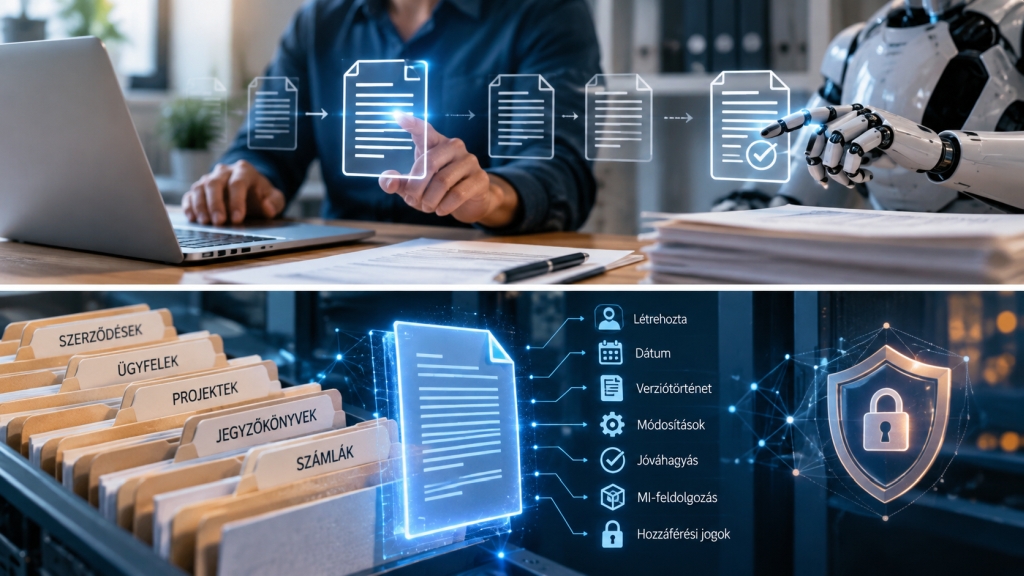
Az iratkezelés digitalizációjáról sokáig úgy beszéltünk, mint a papír eltűnéséről: kevesebb dosszié, gyorsabb keresés, elektronikus archiválás. A mesterséges intelligencia terjedésével azonban ennél jóval érdekesebb probléma kerül előtérbe. Mi történik akkor, amikor egy dokumentumot már nem feltétlenül ember ír, egy beérkező irat tartalmát algoritmus értelmezi, a rendszer automatikusan osztályoz, kivonatot készít, adatokat emel ki, sőt akár további dokumentumokat is létrehoz? A következő évek iratkezelésének egyik kulcskérdése ezért nem egyszerűen az lesz, hogy megtalálható-e egy irat, hanem az, hogy bizonyítható-e az eredete, változatlansága és története. Furcsa módon éppen az MI teheti újra fontossá az iratkezelés egyik legrégebbi alapelvét: minden dokumentumról tudnunk kell, honnan érkezett, mi történt vele, és ki vállalja érte a felelősséget.
Az MI korában a dokumentum eredete értékesebb lehet, mint maga a fájl
Egy hagyományos digitális irattárban hajlamosak vagyunk magát a fájlt tekinteni a megőrzendő értéknek. Ott van a PDF, megvan a szerződés, előkerült a levél – tehát látszólag minden rendben. Csakhogy egy fájl önmagában egyre kevesebbet árul el. Nem feltétlenül derül ki belőle, hogy milyen rendszerben keletkezett, ki hagyta jóvá, módosították-e, melyik változat tekinthető véglegesnek, illetve részt vett-e mesterséges intelligencia az elkészítésében. Emiatt a modern iratkezelés egyik legértékesebb rétege nem feltétlenül maga a dokumentum, hanem a hozzá kapcsolódó metaadatok és események láncolata. A jövő digitális irattára így kevésbé hasonlíthat egy fájlszekrényre, és sokkal inkább egy dokumentum teljes életútját megőrző „fekete dobozra”.
Ennek jelentőségét könnyű egy egyszerű példán keresztül megérteni. Tegyük fel, hogy egy vállalkozás két év múlva elővesz egy fontos, PDF-formátumban tárolt dokumentumot. A fájl olvasható, a tartalma életszerű, szerepel rajta név és dátum is. De vajon ez volt a jóváhagyott változat? Milyen rendszerből származik? Volt korábbi verziója? Mikor került az archívumba? Megváltozott azóta? Ezekre a kérdésekre nem a PDF szövege ad megbízható választ, hanem az iratkezelési környezet. A magyar szabályozásban is központi szerepet kap az elektronikus dokumentum hitelessége és változatlansága, valamint bizonyos esetekben az időbélyegzés, az elektronikus aláírás vagy bélyegző. Vagyis a digitális irat valódi értéke nem pusztán az, amit látunk, hanem az is, amit bizonyítani tudunk róla.
A mesterséges intelligencia azért teszi ezt különösen aktuálissá, mert drasztikusan csökkenti a meggyőző dokumentumok előállításának költségét és idejét. Egy üzleti levél, jegyzőkönyv, jelentés vagy többoldalas szakmai anyag pillanatok alatt létrejöhet úgy, hogy nyelvileg teljesen hitelesnek tűnik. Ettől az irat nem válik automatikusan hamissá vagy használhatatlanná, de a külső megjelenés egyre kevésbé bizonyít bármit az eredetéről. Éppen ezért felértékelődhetnek azok a rendszerek, amelyek nemcsak eltárolják a végleges fájlt, hanem rögzítik a keletkezés és jóváhagyás fontos állomásait is. A dokumentumkezelés tehát egyre inkább bizalomkezeléssé válhat: nem elég megmutatni az iratot, annak megbízható történetét is meg kell őrizni.
Megérkezik az MI az irattárba – de ki ellenőrzi az algoritmust?
A mesterséges intelligencia óriási lehetőséget jelent az iratkezelésben, mert éppen azokat a feladatokat képes felgyorsítani, amelyek nagy dokumentummennyiségnél rengeteg emberi munkaórát emésztenek fel. Felismerheti a dokumentum típusát, kinyerheti a dátumokat, neveket vagy ügyazonosítókat, összefoglalhat hosszú szövegeket, illetve javaslatot tehet arra, milyen ügyhöz vagy kategóriához tartozzon egy beérkező irat. Egy több tízezer dokumentumot kezelő szervezetnél ez már nem egyszerű kényelmi funkció. A keresés és feldolgozás egész logikáját megváltoztathatja. A munkatársnak nem feltétlenül kell tudnia, melyik mappában vagy milyen fájlnéven található valami: természetes nyelven kérdezheti meg a rendszertől, mely dokumentumok kapcsolódnak egy adott ügyhöz.
Itt azonban megjelenik egy érdekes iratkezelési paradoxon. Minél több feladatot adunk át az MI-nek, annál fontosabbá válik annak dokumentálása, hogy pontosan mit végzett el a gép. Ha például egy algoritmus automatikusan besorol egy iratot, majd ennek alapján más megőrzési szabály vagy jogosultság vonatkozik rá, akkor egy téves osztályozásnak már valódi következménye lehet. Ugyanez történhet egy pontatlanul kivont dátummal vagy rosszul azonosított szerződéssel. A jó MI-alapú iratkezelés ezért nem attól „okos”, hogy láthatatlanul mindent automatizál. Sokkal értékesebb lehet az a megoldás, amely visszakövethetővé teszi az automatizált műveleteket, és világosan elválasztja a gépi javaslatot az ember által jóváhagyott döntéstől.
Ez a különbségtétel azért is fontos, mert az Európai Unió mesterséges intelligenciára vonatkozó szabályozása egyre nagyobb hangsúlyt helyez az átláthatóságra, miközben Magyarországon külön MI Hivatal is működik. Bizonyos MI-használati helyzetekben tájékoztatási kötelezettségek is megjelennek, így a vállalati dokumentumfolyamatok tervezésekor már nem kizárólag technológiai kérdés, hol és hogyan alkalmaznak algoritmusokat. Egy iratkezelő rendszerben ezért idővel ugyanolyan természetessé válhat az MI-vel kapcsolatos események naplózása, mint ma a felhasználói műveleteké. Elképzelhető, hogy egy dokumentum történetében nemcsak azt látjuk majd, ki módosította, hanem azt is, melyik automatizált folyamat dolgozta fel, milyen adatot emelt ki belőle, és mely eredményt hagyta jóvá végül egy ember.